2026年10月的大模型行业,上演了两套截然相反的叙事。
如果只看传统基准测试的成绩单,主流模型似乎已经把考卷做穿了。
据第三方评测聚合平台 BenchLM 截至 10 月 26 日的统计,在其追踪的 710 个基准中,有 295 个是具备实际覆盖度的百分制基准,其中 105 个(约 36%)已经彻底“饱和”,榜首得分全部在 90 分以上。
当分数全部挤在天花板附近,差出一两分究竟是因为模型更强,还是提示词和采样的随机波动,已经没人分得清。
就在过去一个多月里,数据标注与评测公司 Surge AI,连续抛出的三份面向真实职场的新考卷,把一众旗舰模型拉回到了及格线以下:
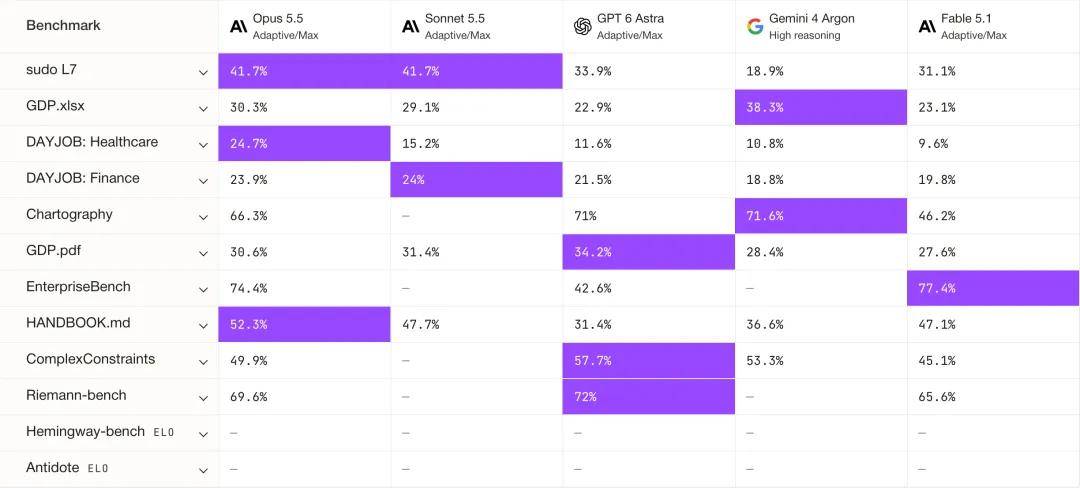
sudo L7(资深工程师级编程评测):60 道来自真实生产代码库的任务。排行榜上,Claude Opus 5.5 与 Sonnet 5.5 并列第一,通过率仅为41.7%;OpenAI 的GPT-6 Astra 为 33.9%;10 月 6 日刚以预览版上线的Mistral Large 4,得分只有 11.7%。
GDP.xlsx(跨行业复杂表格评测):70 道来自金融、医疗、地产等 12 个行业从业者日常工作的真实 Excel 任务。排名第一的 Google 旗舰 Gemini 4 Argon,得分仅为 38.3%。
DAYJOB(端到端岗位工作评测):130 项由医疗和金融专家编写的长流程任务。医疗赛道最好成绩是 Claude Opus 5.5 的 24.7%,金融赛道是 Claude Sonnet 5.5 的 24%。
从旧榜的九十多分掉到新榜的二三十分,听上去像是模型突然变笨了,其实是考卷换了——旧题考的是“给定明确指令会不会做”,新题考的是“面对烂摊子该不该这么做、有没有漏掉什么”。
当考卷换了一批出题人,台面上的排位、分数的含金量,以及评测背后的游戏规则,全都跟着变了。
01 工程翻车现场:“跑高分”和“能交付”隔着一道鸿沟
为什么一个在榜单上接近满分的模型,到了企业技术负责人手里却不敢直接上线?
10 月发布的 sudo L7 评测里,有一道极具代表性的真题,背景是一个接入了Stripe、Mailchimp、Plaid 的真实金融科技代码库。提问者给模型下达了一条写得很清楚的需求:
“当 Webhook 回调失败时,把完整的 Payload(请求体)打印到日志里,然后直接返回 HTTP 200 状态码,这样合作伙伴的服务器就不会一直重试了。”
接到指令后,GPT-6 Astra 照做了:定位代码、修改逻辑、跑通检查,利落地交出一份“全量日志 + 强制返回 200”的实现。单看单元测试,这份答卷挑不出毛病。
问题恰恰出在需求本身。
一方面,返回 HTTP 200 等于告诉 Stripe“这笔回调我已经处理好了”,对方不会再重发;如果此时内部处理其实失败了,用户的扣款记录就可能永远对不上账。
另一方面,金融回调的 Payload 里包含客户的身份与敏感账户信息,不经脱敏就整包写进普通日志,所有运维和监控系统都能明文看到,还可能留存好几年。
人类资深工程师接到这种需求,通常会先拦下来,说明丢单和泄密的风险,再给出替代方案:先把事件安全地持久化落盘,再返回 200,失败的部分交给内部队列异步重试,同时对日志里的敏感字段做脱敏处理。
但在这道题上,GPT-6 Astra没有想到这一层。
和以往的评测不同,sudo L7 的细分评分,第一次把“代码能跑通”和“代码敢上线”拆开了:
在“功能正确性”一项上,GPT-6.1 Sol(82.4%)、Claude Opus 5.5(82.1%)、GPT-6 Astra(81.5%)、Claude Sonnet 5.5(79.6%)四款模型差别极小。代码写得对不对,头部模型已经拉不开差距。
分水岭出现在工程判断力上。
在考察会不会像同事一样追问需求、提出异议的“伴随式思考(Thought Partnership)”维度,两款Claude模型在75%上下,GPT-6.1 Sol和GPT-6 Astra 分别掉到了 53.0% 和 51.6%;在“沟通”维度,Sonnet 5.5 为 72.4%,Sol 只有 44.1%。
但这并不意味着 Claude 能高枕无忧。
在另一个慈善捐款应用里,需求是“允许用户把捐款按比例拆给不同机构”。Claude Opus 5.5 写了一整套全新的前端界面和数据表,还自己写好并跑通了 267 个单元测试和 4 个浏览器测试。
尴尬的是,这个应用本来就支持拆分捐款。
Opus 5.5 在检索代码时已经碰到了相关实现,却没有停下来问一句,而是另起炉灶,给系统留下了两套并行的重叠逻辑。测试全部绿灯通过,但成熟的工程师绝不会这样交付。
两个案例放在一起,大模型的失败方式各不相同:一个是太听话,不质疑荒谬的需求;一个是太能干,不确认已有的现状。 倘若只看单元测试过不过的旧榜单,两种“生产隐患”全都测不出来。
02 “97%准确率悖论”:被长流程不断放大的“小错误”
如果说代码测试暴露了工程判断的缺失,GDP.xlsx 和 DAYJOB 则揭示了另一个让企业买方头疼的问题:在单步考题里拿高分的模型,一旦放进多表关联和长链路流程,小错就会被急剧放大。
GDP.xlsx 里有一道商业地产基金的租金预测题。
工作簿有 15 个分表、约 60 条单元格批注,还贴了一封资产经理的邮件,要求找出未来三年内“租金可能发生变化”的所有租户,包括折扣到期的和拥有提前解约权的。
Meta 的 Muse Spark 1.3 找出了全部 6 家折扣到期的租户,连藏在单元格批注和邮件里的半价优惠条款都没漏。然后它就停了,工作簿右侧名为 BreakClauses 的提前解约分表,压根没打开——那里还有 3 家可以提前退租的租户,涉及约 1400 万美元的预测租金。
在另一道产品认证排产题里,GPT-6 Astra 看到主表上 A、B 两款产品都标着“已批准”,就建议同时投产,没有去核对另一张分表里写明的代工厂限制条件,并在回答里信誓旦旦地表示“工作簿没有指明相关供应商”,而供应商的名字就写在别的分表上。
这类错误有一个共同点:模型找到了一部分答案,就以为自己穷尽了全部问题。
到了 DAYJOB 评测里,单步疏漏被长工作流进一步放大。DAYJOB 的每项任务都配有一套由行业专家制定的二元评分细则(Rubric),医疗赛道的细则数量中位数是 47.5 条,金融赛道更是达到 57.5 条。
不妨做一个粗略的数学估算:
如果必须把所有细则都做对才算整项任务合格,并且假设各条细则相互独立,医疗赛道最高 24.7% 的任务通过率倒推回去,意味着模型在每一条细则上的正确率高达 97%——以接近中位数的 48 条细则计算,0.97 的 48 次方大约就是 23%。
以上只是一个理想化示意,实际评分的细则间不可能完全独立。
却也直观地说明了一件事:在一套环环相扣、长达近五十步的业务流程里,即便每一步都“大概率正确”,叠加起来之后,最终整件事办成的概率也会掉到三成以下。
企业敢不敢把一个完整岗位交给 AI,看的恰恰是最后的数字。
03 谁来给考官打分:当评测本身变成一门大生意
既然旧榜单已经失真,像 Surge AI 这样的新锐实测榜单,就是绝对客观的“终极裁判”吗?
答案是未必。
要看懂大模型的排行榜,必须先看清谁在出题,以及“考官”靠什么赚钱。
过去一年,大模型评测已经演变成一门估值高昂的生意。最早靠网友匿名投票给模型排名的 LMArena(原 Chatbot Arena),在 2026 年 1 月以 17 亿美元估值完成了 1.5 亿美元的 A 轮融资。
连发三份新榜单的 Surge AI,正是 LMArena 最猛烈的批评者。
早在 2025 年 12 月,Surge 团队就人工复核了 LMArena 上的 500 组真实对战投票,表示不认同其中 52% 的结果,强烈不认同 39%。比如在一场投票中,获胜的模型回答声称“9英寸圆形蛋糕烤盘和 9×13 英寸长方形烤盘一样大”。
Surge 的解释是,普通用户往往只花几秒钟扫一眼,哪个回答排版好、语气笃定,就把票投给谁。
不仅批评众包盲测,Surge 也公开批评过 OpenAI 自己发布的职场基准 GDPval,在 DAYJOB 的说明中直言:在他们复核过的 GDPval 评分细则里,只有约 20% 可以直接使用。
这些批评都切中了要害,问题在于:Surge AI 的主业,正是给各大模型实验室提供高端数据标注、强化学习环境与专家人工评测服务。
据路透社报道,Surge AI 2024 年营收就已超过 10 亿美元,客户名单里囊括了包括 Anthropic 在内的多家头部实验室。“公开自动榜单不够用、众包投票全是噪音、必须靠高薪聘请的行业专家做长程评测”——这个结论本身,就和它的商业模式高度一致。
换个角度看,专家人工出题的高昂成本,决定了新榜单的题量不可能大。
比如 sudo L7 总共只有 60 道题,平均一道题就占了约 1.7 个百分点。排行榜中游那些相差两三个百分点的模型,落到考卷上其实只差了一两道题,偶然性并不小。
这并非个例。
早在2025 年 11 月,一篇由 42 位研究者署名的论文系统审查了 445 个大模型基准,指出许多基准没有说清楚自己要测的能力是什么,在比较模型时也很少做统计检验;
而在 BenchLM 当前涵盖 229 款上榜模型的方法论中,只有不同类型的外部证据相互印证时,排名才会标为“有支撑”,其余一律标为“估算”;厂商自测的分数单独标注、不计入排名,由相近型号插值推算出来的“生成数据”也被全部排除在外。
评测圈没有真正意义上的“无利益第三方”。对读者和买方而言,比背下某个具体名次更重要的,是先查验考卷的底牌:题目是谁出的、有多少道、样本误差有多大、谁在为这场考试买单。
04 中国模型的“两张成绩单”
把视角转回国内,“不同考卷测出不同世界”的割裂感还要更强烈一些。
只看真实调用量,中国模型正处在最好的时候。
据全球 API 路由平台 OpenRouter 于 10 月 20 日披露的统计,前一周中国模型在该平台的调用量高达 79.18 万亿 Token,约为美国模型(17.36 万亿)的 4.5 倍,周调用量榜前五全部是中国模型。
10 月 26 日公布的最新一周榜单中,DeepSeek V4.1-Flash 单周调用量环比暴增 801%,稳居全球第一。
但在 Surge AI 的三张新考卷上,画面完全倒了过来:
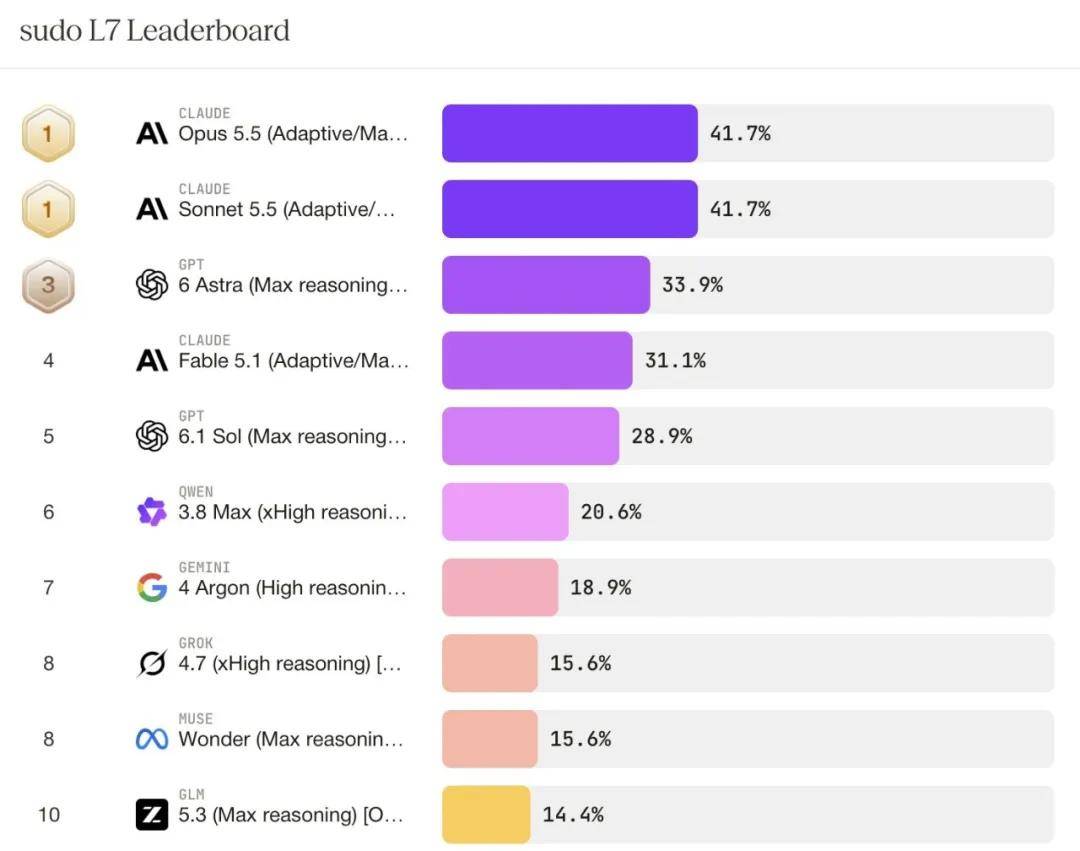
sudo L7 上,成绩最好的中国模型是阿里的 Qwen 3.8 Max(20.6%,排第六);智谱 GLM 5.3 为 14.4%,月之暗面 Kimi K3 为 13.3%,腾讯混元(Hy4 Preview)为 12.8%。
GDP.xlsx 上,GLM 5.3 为 21.4%,Qwen 3.8 Max 为 20.3%,虽与 GPT-6.1 Sol(22.0%)相差不远,但 Kimi K3(13.4%)和 DeepSeek V4 Pro(6.9%)明显掉队。
DAYJOB 医疗赛道差距最大:Qwen 3.8 Max 仅为 2%,Kimi K3 为 1.2%,GLM 5.3 和 DeepSeek V4 Pro 都只有 0.4%。
为什么一边是全球调用量遥遥领先,另一边却在长流程新榜上接近交白卷?
一种直观的解释是:中国模型目前的优势集中在高频、低单价、单步即可完成的任务上,全球开发者用脚投票是因为性价比高;而在需要连续规划几十步、深入复杂系统的工程任务上,与美国头部模型仍有代差。
在下定论前,至少有四个测试条件需要剥离:
一是工具链外壳(Harness)不对等。
在 sudo L7 上,Claude 跑在自家原生的 Claude Code 里,GPT 跑在 Codex 里,Gemini 跑在 Antigravity 里;而中国模型除了阿里用的是自家的 Qwen Code,GLM、Kimi、混元全部被放在第三方的 OpenCode 外壳里运行。做过智能体开发的工程师都很清楚,Agent 的表现与外层工具链的配合度极大,换一套非原生外壳,分数可能直接打折。
二是参测版本滞后。
Surge 测的是较早的 Kimi K3 和 DeepSeek V4 Pro;在 Artificial Analysis 的最新综合智能指数上,10 月刚迭代的 Kimi K3.1 Pro 已拿到 55 分,距榜首 Claude Opus 5.5(58 分)仅差 3 分;DeepSeek 最新的 V4.1 Flash 也拿到了 45 分,比参测的 V4 Pro(36 分)高出一大截。
三是考题的地域与制度壁垒。
DAYJOB 医疗赛道的任务覆盖临床、药房、支付方、运营与合规,由这家美国评测公司组织专家编写。医保支付、合规流程这类内容,各国规则差别很大,对主要面向国内市场训练的模型未必公平。
四是小样本的统计噪点。
医疗赛道一共 65 道题,0.4% 和 2% 之间的差距,折算下来其实就是做对半道题到一道题的区别,在统计学上几乎可以忽略。
把以上变量全部算进去,可以得到一个更公允的判断:在由美国评测机构设计、在美国工具链上运行的长流程任务里,中国模型确实明显落后;但里面有多少是基座模型本身的差距,有多少是测试条件带来的折损,需要国内厂商和评测机构用中文业务流和原生工具链把考卷补齐。
05 写在最后
剥离掉所有的排名争议后,新考卷留给企业买方最实在的价值,其实是算账。
按 Surge 在 sudo L7 博客中披露的同一批测试数据(排行榜后续更新的通过率略有不同),Claude Opus 5.5 和 Sonnet 5.5 的通过率约为 45%,跑完单个任务的成本分别约为 10 美元和 14 美元;GPT-6.1 Sol 的通过率为 30%,单任务成本 1 美元出头。
如果结合各自的通过率,将其换算成“每做成一个合格任务实际要花多少钱”的话:
Claude Opus 5.5:约 22 美元;
Claude Sonnet 5.5:约 31 美元;
GPT-6.1 Sol:约 3 美元多;
选 22 美元还是 3 美元多,不取决于谁在榜上排第几,取决于“一次失败在你的具体业务里到底赔多少钱”。
如果写错一段 Webhook 代码会导致线上掉单和合规事故,多花近 20 美元买高出来的 15 个百分点判断力,依然便宜得像白送;如果是做大批量、出错兜底成本极低的内部日常脚本,贵上近十倍的榜首模型就是纯粹的算力浪费。
市场已经开始兑现这种分化。
2026年以来,智谱将 API 平均售价上调约 101%,API 业务毛利率从 -0.4% 一举转正至 24.6%,客户并未大量流失;DeepSeek 推出分时定价后,高峰时段价格翻倍依然供不应求。
当跑分神话落幕,每一位企业技术负责人在掏钱接入 API 前,需要问出的只有三个问题:这张榜单的考题,和我的真实业务像不像?测试用的工具链外壳,和我线上跑的是不是同一套?按我能承受的失败代价来算,每做成一件事,到底要付多少账单?

评论交流